#
Outils et modèles
Au 12 octobre 2026, Claude Opus 5.5 d'Anthropic est le modèle le mieux noté par l'indice indépendant d'Artificial Analysis, avec 58 points. Suivent Claude Sonnet 5.5 (56) puis trois modèles à égalité à 53 : Claude Fable 5.1, GPT-6 Astra d'OpenAI et Gemini 4 Argon de Google
Le classement des votes des utilisateurs de LMArena donne un autre ordre : Gemini 4 Argon y est premier en écriture, avec un score encore provisoire, devant Claude Opus 5.5. Pour coder des sites et des applications, Claude Opus 5.5 mène devant GPT-6 Astra
Ce classement réunit les deux références, toutes marques confondues, et te dit quel modèle prendre selon ton usage
Le classement général en un tableau
L'indice d'Artificial Analysis agrège 10 évaluations : travail de bureau en mode agent, automatisations, code dans un terminal, raisonnement scientifique, connaissances, documents longs. Chaque modèle y est testé à plusieurs niveaux de réflexion. Le tableau garde le meilleur score de chaque modèle
Rang | Modèle | Éditeur | Score Artificial Analysis | Coût moyen par tâche |
|---|---|---|---|---|
1 | Claude Opus 5.5 | Anthropic | 58 | 5,98 $ |
2 | Claude Sonnet 5.5 | Anthropic | 56 | 5,46 $ |
3 | Claude Fable 5.1 | Anthropic | 53 | 7,63 $ |
3 | GPT-6 Astra | OpenAI | 53 | 3,26 $ |
3 | Gemini 4 Argon | 53 | 1,99 $ | |
6 | GPT-6.1 Sol | OpenAI | 52 | 0,72 $ |
7 | Muse Spark 1.3 | Meta | 48 | 1,60 $ |
8 | Grok 4.7 | SpaceXAI | 46 | 3,74 $ |
8 | MiMo-V2.6-Pro | Xiaomi | 46 | 0,13 $ |
10 | Qwen3.8 Max | Alibaba | 45 | 5,41 $ |
10 | GLM-5.3 | Z AI | 45 | 2,01 $ |
12 | Kimi K3 | Moonshot | 44 | 2,00 $ |
Source : Artificial Analysis Intelligence Index v4.3.2, consulté le 12 octobre 2026. Le coût est le coût moyen par tâche de l'indice publié par Artificial Analysis : le prix de l'API pour une tâche, pondéré selon le poids de chaque évaluation. Il donne une idée du prix relatif, pas de ce que tu paieras dans un abonnement
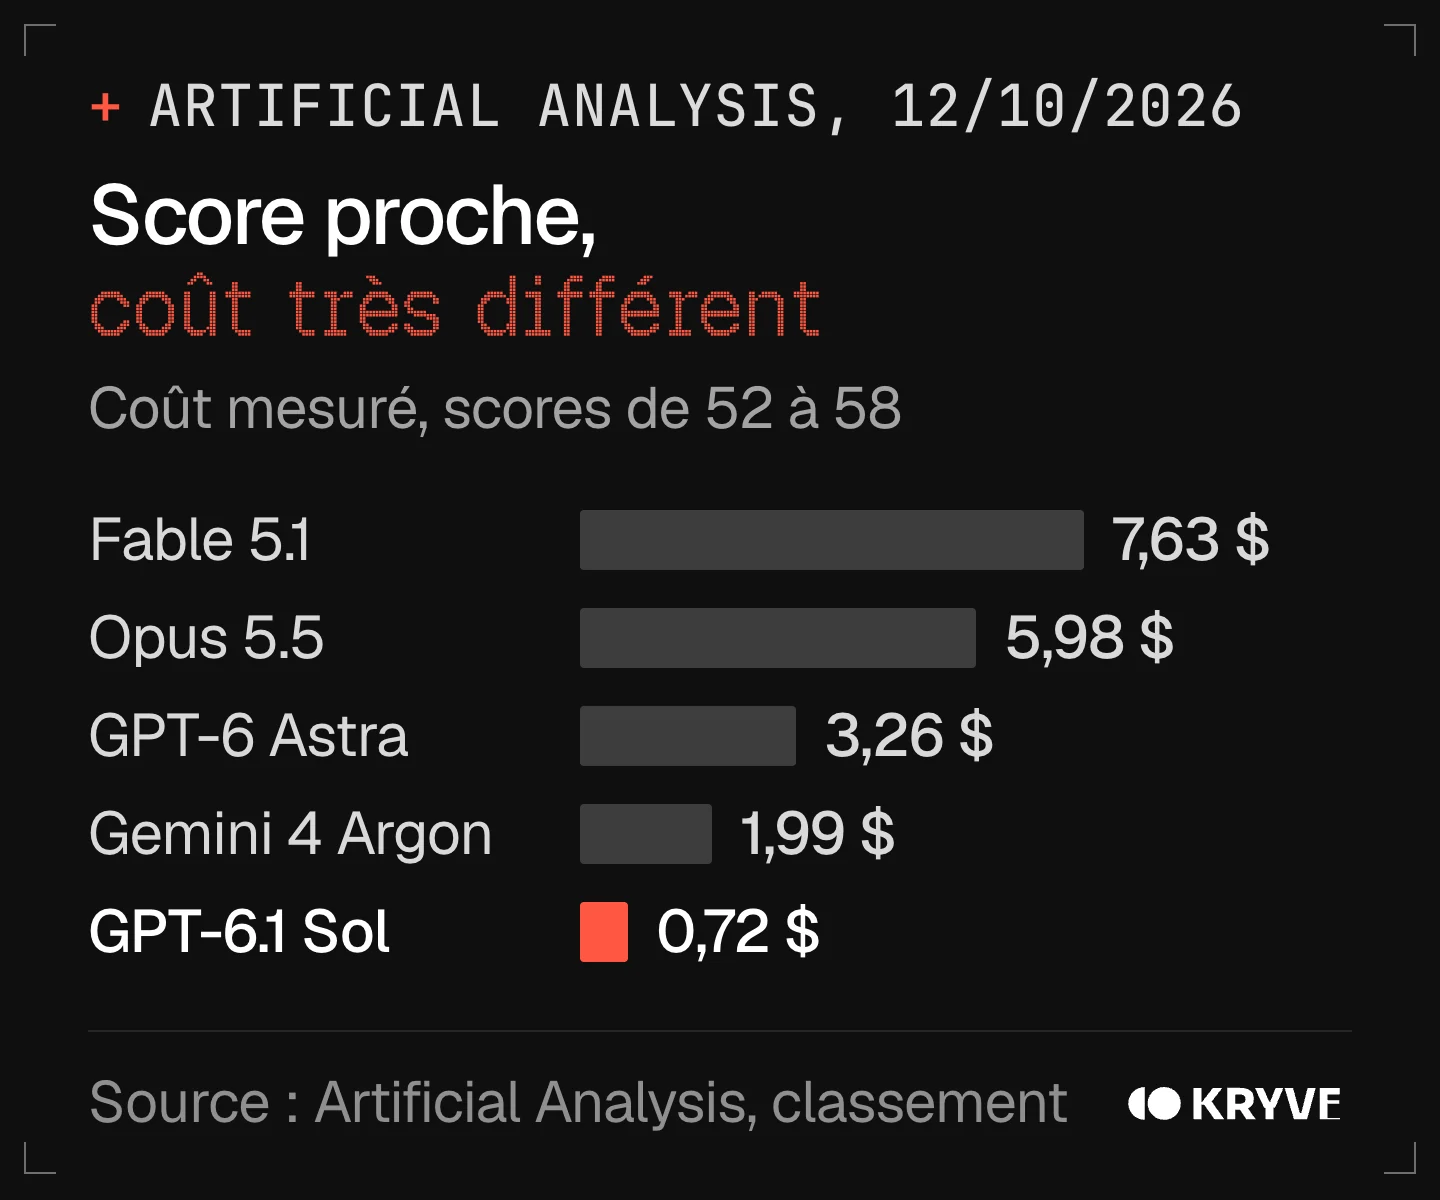
Coût moyen par tâche de l'indice, mesuré par Artificial Analysis pour les modèles en tête du classement, consulté le 12 octobre 2026
Trois lectures rapides. Anthropic occupe les 2 premières places et OpenAI, Google et Anthropic se tiennent en 1 point juste derrière. GPT-6.1 Sol fait presque aussi bien que les meilleurs pour un coût par tâche 8 fois plus faible que Claude Opus 5.5. Et les modèles chinois à poids ouverts, comme MiMo-V2.6-Pro de Xiaomi, ne sont plus qu'à 12 points du sommet
Deux classements, deux méthodes
Artificial Analysis fait passer les mêmes épreuves à tous les modèles et note les résultats. C'est la bonne référence pour comparer ce qu'un modèle sait faire sur des tâches de travail mesurables
LMArena fait voter les internautes à l'aveugle : tu poses une question, deux modèles anonymes répondent, tu choisis la meilleure réponse. Le classement texte du 8 octobre 2026 s'appuie sur 8 734 330 votes. C'est la bonne référence pour savoir quelle réponse les gens préfèrent lire
Les deux ne mesurent pas la même chose, d'où des écarts. Un modèle très bon en tâches d'agent peut écrire de façon moins agréable, et l'inverse
Le classement des votes (LMArena, texte)
Rang | Modèle | Éditeur | Score |
|---|---|---|---|
1 | Gemini 4 Argon (réflexion élevée) | 1525, provisoire | |
2 | Claude Opus 5.5 (réflexion élevée) | Anthropic | 1507 |
3 | Claude Opus 4.6 (réflexion élevée) | Anthropic | 1504 |
4 | Claude Fable 5 (réflexion élevée) | Anthropic | 1504 |
5 | Claude Opus 4.7 (réflexion élevée) | Anthropic | 1501 |
6 | Claude Fable 5.1 (réflexion maximale) | Anthropic | 1501 |
7 | Claude Opus 4.6 | Anthropic | 1498 |
8 | Gemini 3.8 Flash (réflexion élevée) | 1497, provisoire | |
9 | Muse Spark 1.3 (réflexion maximale) | Meta | 1494 |
Source : LMArena, classement texte mis à jour le 8 octobre 2026. « Provisoire » signifie que le modèle a encore peu de votes : 4 892 pour Gemini 4 Argon, contre plus de 79 000 pour Claude Opus 4.6
Gemini 4 Argon est testé en avant-première sur LMArena, mais il n'est pas encore ouvert au public. Notre guide Gemini 4 Argon fait le point sur l'accès et les prix annoncés
Le meilleur modèle selon ton usage
Usage | En tête du classement | Source |
|---|---|---|
Écrire, discuter, répondre à des questions | Gemini 4 Argon (provisoire), puis Claude Opus 5.5 | LMArena texte, 8 octobre |
Travail de bureau et tâches d'agent | Claude Opus 5.5, puis Claude Sonnet 5.5 | Artificial Analysis, 12 octobre |
Coder un site ou une application | Claude Opus 5.5 (1813), GPT-6 Astra (1786), Claude Sonnet 5.5 (1774) | LMArena WebDev, 8 octobre |
Réponses factuelles fiables | Claude Opus 5.5 (46), GPT-6 Astra (44), Claude Fable 5.1 (43) | AA-Omniscience, 12 octobre |
Générer des images | GPT Image 2.5 Sunburst (provisoire), GPT Image 2.5 Flare (provisoire), GPT Image 2 | LMArena image, 7 octobre |
Petit budget | GPT-6.1 Sol (52 pour 0,72 $), MiMo-V2.6-Pro (46 pour 0,13 $) | Artificial Analysis, 12 octobre |
Pour écrire au quotidien, les écarts entre les premiers sont faibles : prends l'assistant que tu as déjà et apprends à bien le briefer. Notre comparatif Gemini vs ChatGPT vs Claude t'aide à choisir l'abonnement
Pour coder, le podium est net. Notre comparatif Codex vs Claude Code compare les deux outils qui utilisent ces modèles, et notre article sur DeepSWE explique comment on mesure les agents de code
Pour les faits, aucun modèle n'est sûr à 100 %. Le meilleur répond juste à 67 % des 6 000 questions de l'épreuve AA-Omniscience. Notre article sur les hallucinations de l'IA explique pourquoi et comment t'en protéger
Pour les images, OpenAI occupe les 3 premières places du vote. Notre guide pour créer des images avec l'IA présente les outils gratuits
Les meilleurs modèles open source
Les modèles à poids ouverts se téléchargent et peuvent tourner sur tes propres serveurs. En octobre 2026, les meilleurs viennent de Chine
Modèle | Éditeur | Score Artificial Analysis | Licence indiquée par LMArena |
|---|---|---|---|
MiMo-V2.6-Pro | Xiaomi | 46 | MIT |
GLM-5.3 | Z AI | 45 | MIT |
Kimi K3 | Moonshot | 44 | Licence Kimi K3 |
DeepSeek V4.1 Flash | DeepSeek | 39 | MIT |
Côté européen, Mistral Large 4 obtient 38 en préversion. Mistral prévoit de publier ses poids, voir notre guide Mistral Large 4. Pour en faire tourner un sur ton ordinateur, lis notre guide pour faire tourner une IA en local
Et les versions gratuites ?
Les modèles en tête du classement sont surtout dans les forfaits payants. Les versions gratuites des grands assistants utilisent des modèles plus légers, notés ainsi par Artificial Analysis selon le niveau de réflexion :
Version gratuite | Modèle | Score Artificial Analysis |
|---|---|---|
Claude gratuit | Claude Sonnet 5.5 et Haiku 5.5 | de 29 à 56 selon le modèle et la réflexion |
ChatGPT gratuit | GPT-6 Luna | de 18 à 38 selon la réflexion |
Gemini gratuit | Gemini 3.5 Flash-Lite | 22 |
Le gratuit de Claude donne accès au modèle le mieux noté des trois, avec des limites d'usage plus serrées. Le gratuit de ChatGPT est le plus généreux en volume. Le détail des forfaits est dans notre comparatif Gemini vs ChatGPT vs Claude
Comment lire un classement d'IA sans te tromper
Le niveau de réflexion change tout : Claude Opus 5.5 passe de 42 points en réflexion faible à 58 en réflexion maximale. Un même modèle peut être 1er ou 30e selon le réglage
Les petits écarts ne veulent rien dire : sur LMArena, chaque score a une marge d'erreur de 3 à 10 points. Les modèles à égalité dans cette marge se valent
« Provisoire » veut dire peu de votes : attends quelques semaines avant de conclure sur un nouveau modèle
Le coût compte autant que le score : un modèle à 52 points pour 0,72 $ par tâche peut être un meilleur choix qu'un modèle à 58 points pour 5,98 $ par tâche si tu l'utilises toute la journée
Ton cas d'usage passe avant le classement : teste 2 ou 3 modèles sur une vraie tâche à toi. Notre méthode pour évaluer la fiabilité d'un modèle IA t'y aide
FAQ
Quelle est la meilleure IA en ce moment ?
Au 12 octobre 2026, Claude Opus 5.5 d'Anthropic, avec 58 points sur l'indice d'Artificial Analysis et la 1re place pour coder sur LMArena. Pour la qualité d'écriture jugée par les internautes, Gemini 4 Argon est 1er sur LMArena, mais il n'est pas encore accessible au public
Quelle est la meilleure IA gratuite ?
Pour la qualité, Claude gratuit, qui donne accès à Claude Sonnet 5.5. Pour le volume, ChatGPT gratuit avec GPT-6 Luna. Si tu veux un modèle gratuit sans abonnement à installer chez toi, les modèles open source comme GLM-5.3 ou DeepSeek V4.1 Flash sont sous licence MIT
Quelle IA est la meilleure pour coder ?
Claude Opus 5.5 en réflexion maximale, 1er du classement WebDev de LMArena avec 1813 points, devant GPT-6 Astra (1786) et Claude Sonnet 5.5 (1774)
ChatGPT est-il encore la meilleure IA ?
Son meilleur modèle, GPT-6 Astra, est 3e ex aequo de l'indice d'Artificial Analysis, derrière deux modèles Claude. Pour la plupart des usages du quotidien, la différence se sent peu. Notre guide GPT-6 Astra détaille ce que le modèle apporte
Pourquoi les classements ne donnent-ils pas le même gagnant ?
Parce qu'ils ne mesurent pas la même chose. Artificial Analysis note des épreuves objectives, LMArena compte les préférences des internautes. Un modèle peut réussir les épreuves et écrire de façon moins agréable, ou l'inverse
Ce classement est-il mis à jour ?
Oui, nous le mettons à jour quand un nouveau modèle change le haut du tableau. La date de chaque source est indiquée sous les tableaux
Le classement change chaque mois, la méthode reste
Le modèle en tête aujourd'hui sera dépassé dans quelques semaines. Ce qui dure, c'est savoir choisir le bon modèle pour une tâche, le briefer et vérifier ce qu'il produit
C'est ce que tu apprends dans l'axe Apprendre à piloter l'IA avec Kryve