#
Outils et modèles
Mistral Large 4 est le plus gros modèle jamais sorti par Mistral. Il est disponible depuis le 6 octobre 2026 en préversion publique, uniquement par l'API de Mistral Studio et des plateformes tierces. Ses poids doivent être publiés fin octobre
Concrètement : tu peux le tester dès aujourd'hui si tu es prêt à payer au token. Si tu utilises l'application grand public de Mistral, tu ne peux pas le choisir par son nom. Et tant que les poids ne sont pas sortis, personne ne peut le télécharger pour l'installer chez soi
Ce guide fait le tri entre ce qui existe déjà, ce qui est promis et ce que les chiffres disent vraiment
Mistral Large 4 en bref
Mistral le surnomme officiellement « le Chonk ». Voici ce que dit sa fiche technique, consultée le 12 octobre 2026
Point | Ce qu'on sait |
|---|---|
Annonce | 6 octobre 2026, préversion publique |
Taille | 1,05 billion de paramètres au total, 52 milliards actifs par token selon Mistral |
Entrées | Texte et images, réponse en texte |
Contexte | Jusqu'à 1 million de tokens selon la fiche Mistral |
Accès | API sur Mistral Studio, puis plateformes tierces comme OpenRouter |
Prix standard | 1,36 $ par million de tokens en entrée, 4,18 $ en sortie |
Poids | Promis pour la fin octobre 2026 |
Deux précisions avant d'aller plus loin. Mistral annonce 52 milliards de paramètres actifs, alors qu'Artificial Analysis et plusieurs sites en écrivent 49. Et la fenêtre de 1 million de tokens est celle de la fiche Mistral : certaines plateformes qui revendent le modèle l'exposent avec une fenêtre plus courte. Vérifie la limite chez le fournisseur que tu utilises
Où utiliser Mistral Large 4 aujourd'hui
Sur Mistral Studio, par l'API
C'est le seul accès cité dans l'annonce officielle. Tu crées un compte sur Mistral Studio, tu actives la facturation, tu génères une clé API et tu appelles le modèle. Tu paies chaque token envoyé et reçu
Si tu n'as jamais utilisé d'API, ça demande un petit pas technique. Un agent comme Codex ou Claude Code peut écrire l'appel pour toi, mais garde ta clé hors des fichiers que tu partages
Par des plateformes tierces
Le modèle est apparu le jour même sur des agrégateurs comme OpenRouter, au même prix soldé que chez Mistral au moment de notre lecture. Pratique si tu as déjà un compte sur l'un d'eux ou un outil qui s'y branche
Avant d'y envoyer des documents de travail, lis où tes données transitent. Le modèle a beau venir d'une entreprise française, un intermédiaire peut le servir depuis une autre infrastructure
Et dans Le Chat ?
Le Chat s'appelle désormais Mistral Vibe, avec les mêmes conversations et abonnements. L'annonce de Large 4 ne parle pas de Vibe, et l'application propose des modes plutôt qu'un choix de modèle nommé
Tu ne peux donc pas sélectionner Mistral Large 4 dans Vibe et savoir avec certitude que c'est lui qui répond. Pour le tester en le sachant, passe par l'API
Ce qui change depuis Mistral Large 3
Large 3 date du 2 décembre 2025. La comparaison des deux fiches officielles montre un modèle plus gros, avec beaucoup plus de contexte, mais nettement plus cher
Large 3 | Large 4 | |
|---|---|---|
Paramètres totaux | 675 milliards | 1,05 billion |
Paramètres actifs | 41 milliards | 52 milliards (selon Mistral) |
Contexte | 256 000 tokens | 1 million de tokens |
Entrée par million de tokens | 0,50 $ | 1,36 $ (0,68 $ pendant la remise de lancement) |
Sortie par million de tokens | 1,50 $ | 4,18 $ (2,09 $ pendant la remise de lancement) |
Sources : fiches Mistral Large 3 et Mistral Large 4 de la documentation Mistral
Mistral précise aussi que le modèle a été entraîné de zéro sur 3 800 GPU NVIDIA Grace Blackwell dans ses propres centres de données en Europe, et que la préversion tourne sur cette même infrastructure. Plus de 160 langues sont présentes dans ses données d'entraînement, dont toutes les langues officielles de l'Union européenne
Ce que disent vraiment les benchmarks
Il faut séparer deux familles de chiffres
Les chiffres publiés par Mistral
Dans son annonce, Mistral met en avant :
61,7 % sur DeepSWE v1.1 et 28,3 % sur Terminal-Bench 4 pour le code
93 % des exercices de Cybench et 82 % sur un test qui demande de reproduire puis corriger une vraie faille, en cybersécurité
59,9 % sur AutomationBench, 657 workflows métier dans des outils comme Gmail, Sheets ou Slack
une 2e place sur 5 dans une évaluation humaine en aveugle sur la qualité du code, derrière Claude Opus 5
Ces scores viennent de l'éditeur. Ils montrent où Mistral a concentré ses efforts : cybersécurité défensive, agents, documents et images. Ils ne disent pas comment le modèle se comporte sur tes tâches
La mesure indépendante
Artificial Analysis a testé la préversion le jour de sa sortie. Son indice d'intelligence donne 38 à Mistral Large 4, au niveau de GPT-6 Luna en effort maximal (38) et de DeepSeek V4.1 Flash (39). D'après eux, c'est le modèle le plus intelligent conçu hors des États-Unis et de la Chine
Notre lecture : Mistral revient au niveau des meilleurs modèles ouverts et de GPT-6 Luna, le modèle que ChatGPT sert à ses comptes Free et Go. Dans l'évaluation humaine publiée par Mistral elle-même, Claude Opus 5 reste devant sur la qualité du code. Si tu veux situer GPT-6 Luna, notre guide GPT-6 Sol et Luna explique la gamme d'OpenAI
Le prix réel : regarde le coût par tâche
Le prix au million de tokens ne suffit pas. Un modèle qui réfléchit longtemps consomme plus de tokens pour la même réponse
Artificial Analysis a calculé ce que coûte une tâche de son indice : 1,13 $ au tarif standard, 0,57 $ pendant la remise de 50 % des 2 premières semaines. C'est plus de 4 fois le coût par tâche de modèles ouverts d'intelligence comparable, comme GLM-5.3-Flash (0,25 $) ou DeepSeek V4.1 Flash (0,27 $)
Pour un usage ponctuel, la différence se compte en centimes. Pour un agent qui tourne toute la journée, elle devient le premier critère
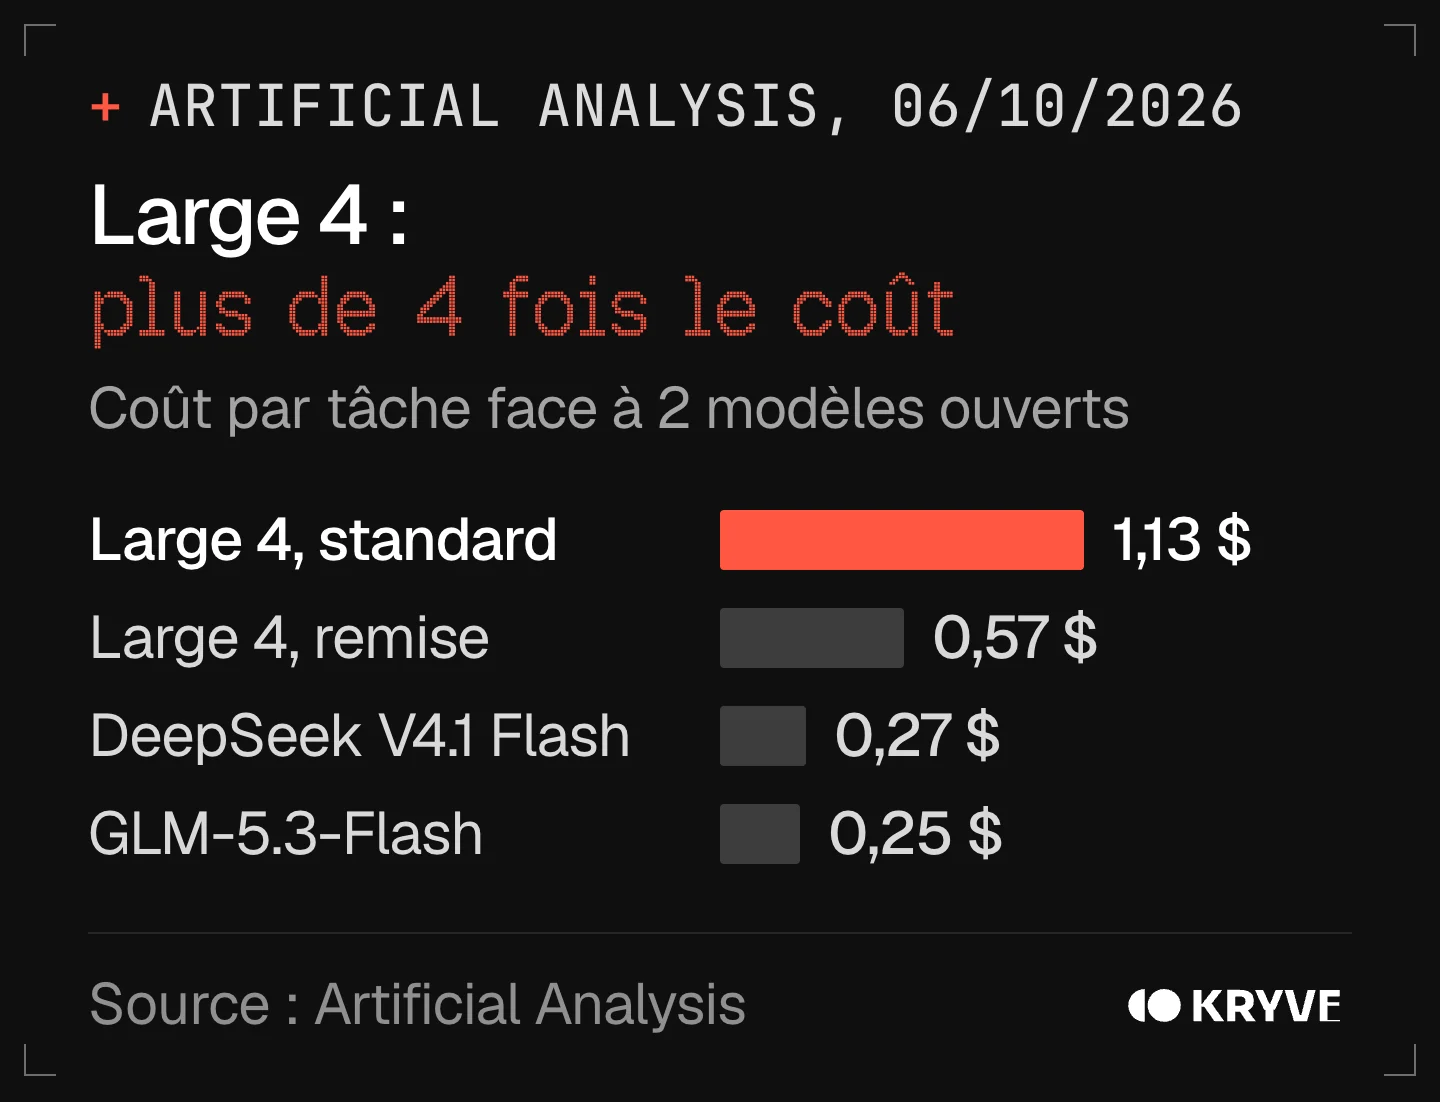
Coût par tâche de l’indice mesuré par Artificial Analysis, publié le 6 octobre 2026
Poids ouverts fin octobre : ce que ça change
Mistral promet de publier les poids du modèle d'ici la fin du mois. Une fois disponibles, une entreprise pourra faire tourner Large 4 sur ses propres serveurs ou dans son cloud privé, sans envoyer ses données à un fournisseur
C'est l'argument principal de Mistral : garder le contrôle de son IA, notamment pour la cybersécurité, où un modèle qui refuse une analyse en plein incident devient un risque
Trois limites à garder en tête :
Aujourd'hui, rien n'est téléchargeable. La licence des futurs poids n'est pas encore précisée dans l'annonce
Un modèle de cette taille demande des serveurs avec beaucoup de mémoire GPU. Ton ordinateur portable ne le fera pas tourner. Pour l'IA sur ta machine, lis notre guide pour faire tourner une IA en local
La préversion peut évoluer sans prévenir : Mistral indique que l'entraînement par renforcement continue
Pour qui Mistral Large 4 vaut le coup
Il mérite un test si tu es dans l'un de ces cas :
Tu travailles avec des données qui ne doivent pas quitter l'Europe et tu prépares une installation interne pour quand les poids sortiront. Notre guide sur la sécurité des données IA en entreprise t'aide à cadrer ce qui peut partir chez un fournisseur
Tu fais de la sécurité défensive : c'est le terrain où Mistral publie ses meilleurs scores
Tu analyses beaucoup de documents, de schémas ou d'images, avec un contexte très long
Tu construis un produit et tu veux un modèle que tu pourras héberger toi-même plus tard
Si tu utilises surtout l'IA pour écrire, chercher ou préparer tes journées dans ChatGPT, Claude ou Gemini, rien ne t'oblige à changer cette semaine. Ton assistant actuel fait déjà ce travail sans clé API. Pour choisir selon la tâche, notre comparatif des outils IA reste le bon point de départ
Le tester sur ton propre travail en 30 minutes
Un benchmark répond à la question de quelqu'un d'autre. Le seul test qui compte pour toi, c'est une tâche que tu fais déjà. Chez Kryve, on recommande ce protocole avant d'adopter n'importe quel nouveau modèle
Choisis 3 tâches réelles dont tu connais la bonne réponse : un document à résumer, un tableau à analyser, un mail délicat à rédiger
Écris un brief unique pour chaque tâche, avec le contexte, le format attendu et ce qu'il ne faut pas inventer
Envoie exactement le même brief à Mistral Large 4 et à ton outil habituel
Note chaque réponse sur 3 critères : exactitude, respect du format, temps que tu passes à corriger
Regarde le coût réel dans ton tableau de bord Mistral Studio
Exemple de brief pour la première tâche :
Voici un compte rendu de réunion. Extrais les décisions prises, les actions avec leur responsable et leur échéance, et les questions restées ouvertes. Si une information manque, écris « non précisé ». N'invente aucun nom ni aucune date
Si Large 4 gagne sur tes tâches, tu as une vraie raison de l'adopter. Sinon, tu sais pourquoi tu restes. La méthode pour évaluer la fiabilité d'une réponse IA t'aide à rendre ce test plus solide
FAQ
Mistral Large 4 est-il gratuit ?
Non. La préversion se paie au token sur Mistral Studio : 1,36 $ par million de tokens en entrée et 4,18 $ en sortie au tarif standard, avec une remise de 50 % pendant le lancement. Une fois les poids publiés, le modèle sera téléchargeable, mais l'héberger demande du matériel coûteux
Mistral Large 4 est-il dans Le Chat ?
Le Chat est devenu Mistral Vibe. L'annonce de Large 4 ne mentionne pas Vibe et l'application ne permet pas de choisir un modèle par son nom. Pour être sûr d'utiliser Large 4, passe par l'API
Mistral Large 4 est-il open source ?
Mistral le présente comme un modèle à poids ouverts. Au 12 octobre 2026, les poids ne sont pas encore publiés et leur licence n'est pas précisée. Il faudra lire cette licence à la sortie pour savoir ce qu'elle autorise
Quand les poids de Mistral Large 4 sortent-ils ?
Mistral annonce une publication d'ici la fin octobre 2026, accompagnée de détails sur l'architecture, de benchmarks supplémentaires et de sa méthode de post-entraînement
Faut-il passer de ChatGPT ou Claude à Mistral Large 4 ?
Pas par principe. Teste-le sur 3 de tes tâches réelles avec le même brief. Le bon modèle est celui qui te fait gagner du temps sur ton travail, au coût que tu acceptes. Si tu utilises Claude, notre guide pour choisir entre Claude Sonnet et Opus t'aide d'abord à tirer le meilleur de ton outil actuel
Choisir son modèle, c'est une compétence
Chaque mois apporte un nouveau modèle et un nouveau classement. Ce qui reste utile, c'est de savoir choisir l'outil selon la tâche, lui donner le bon contexte et vérifier ce qu'il produit
C'est exactement ce que tu travailles dans l'axe Apprendre à piloter l'IA avec Kryve