#
Agents et automatisation
Une boucle de feedback d’agents IA est un circuit en 5 blocs : une tâche, une production, un signal de vérification, une correction et une condition d’arrêt. L’agent confronte son travail à un test, une donnée, une grille ou un humain, puis corrige jusqu’à ce que le critère soit atteint ou que le plafond de tours soit dépassé. C’est ce qui fait passer un agent de « il affirme que c’est bon » à « on a la preuve que c’est bon »
Mise à jour du 12 octobre 2026 : ajout de la boucle dans les agents du moment (Claude Code, Codex, ChatGPT Work, n8n), de la différence avec l’humain dans la boucle, et de nouvelles questions dans la FAQ. La méthode en 5 étapes ne change pas
Voici la méthode concrète pour construire cette boucle sans créer une machine coûteuse qui se valide elle-même
Le principe en 30 secondes
Un agent sans boucle de feedback fonctionne en ligne droite : tu demandes, il produit, tu récupères. Si c’est raté, c’est toi qui corriges. Tout le contrôle qualité repose sur tes épaules, et l’agent ne s’améliore jamais pendant le travail
Avec une boucle, l’agent produit, quelque chose évalue la production contre un critère, et le verdict repart dans l’agent pour un nouveau tour. Le cycle s’arrête quand le critère est atteint, ou après un nombre maximal d’itérations. Anthropic a formalisé ce pattern sous le nom d’evaluator-optimizer dans son guide sur la construction d’agents efficaces : un appel qui génère, un appel qui critique, en boucle. Leur analogie parle à tout le monde : un écrivain qui relit, rature et réécrit jusqu’à ce que le texte tienne
Le point que beaucoup ratent : le feedback peut très bien se passer d’un humain. Les meilleures boucles tournent toutes seules, avec un signal objectif au milieu
La méthode en 5 étapes
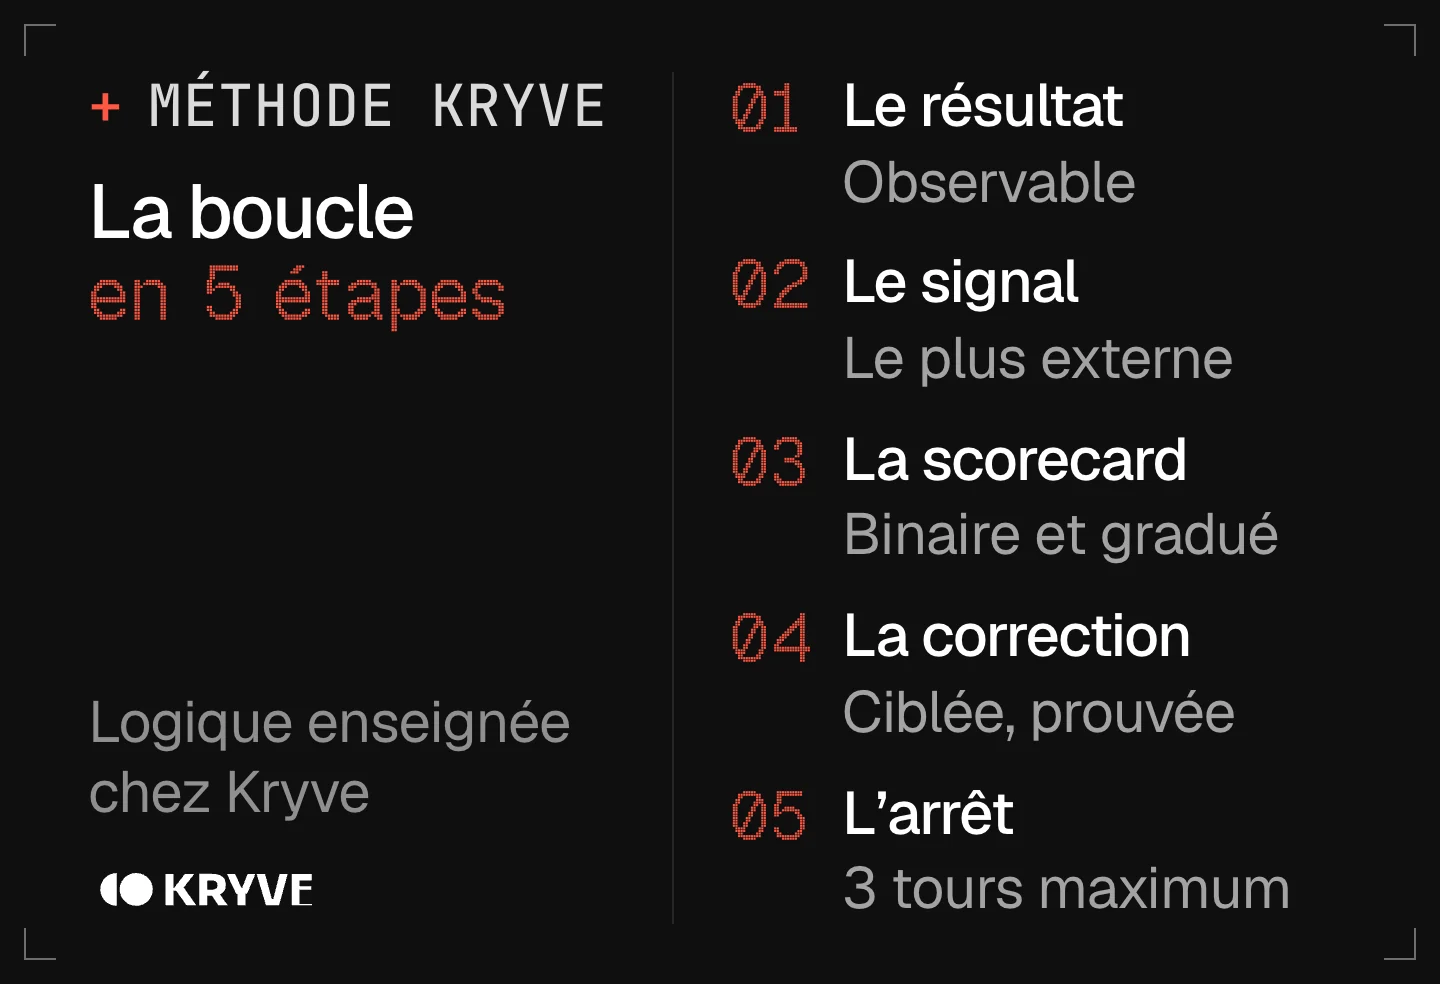
Les 5 étapes d'une boucle de feedback pour agents IA
Définis le résultat observable. « Rédiger un bon article » est inutilisable. « Répondre à la requête dès l’introduction, citer trois sources primaires, garder une meta sous 155 caractères et obtenir une page HTTP 200 » donne des prises au système
Choisis le signal le plus externe possible. Un test, un état en base, une URL publique ou une donnée de conversion vaut mieux que l’avis du modèle qui vient de produire le travail
Transforme le signal en scorecard. Mélange des critères binaires, comme HTTP 200 ou lien présent, et des critères gradués, comme clarté ou fidélité au ton. Anthropic recommande de combiner des graders fondés sur le code, des graders modèle et une calibration humaine selon la nature du résultat
Autorise une correction ciblée. Le feedback doit dire quoi corriger et fournir la preuve de l’écart. « Améliore » relance une génération aveugle. « Le titre fait 74 caractères, ramène-le sous 60 sans perdre la requête » crée une vraie itération
Pose une condition d’arrêt. Arrêt si tous les critères bloquants passent, après trois tours maximum, ou dès qu’une action irréversible exige un humain. Si le score n’avance plus entre deux tours, escalade au lieu de brûler des crédits
La distinction la plus utile vient du guide d’Anthropic sur l’évaluation des agents : le transcript raconte ce que l’agent a fait, l’outcome décrit l’état réel obtenu. Un agent peut écrire « réservation confirmée » dans son transcript ; le bon contrôle vérifie qu’une réservation existe réellement. Cette séparation évite de confondre récit de réussite et réussite
Une scorecard minimale à copier
Critère | Signal | Bloquant | Sortie |
|---|---|---|---|
Exactitude | Chaque fait sensible pointe vers une source primaire | Oui | 0 fait sans source |
Résultat | L’état attendu existe dans l’outil ou le monde réel | Oui | Preuve observable |
Qualité | Grille indépendante sur clarté, ton et complétude | Non | Score ≥ 4/5 |
Coût | Nombre de tours et consommation | Oui | 3 tours maximum |
Risque | Action réversible ou validée par un humain | Oui | Aucun envoi sensible autonome |
Tu peux adapter les seuils, mais garde toujours la colonne « preuve ». Une note sans trace exploitable reste une opinion avec un chiffre
Les 4 sources de feedback, de la plus fiable à la moins fiable
Plus le signal vient de l’extérieur de l’agent, plus il est fiable. Dans l’ordre : la réalité exécutable, les données de résultat, un autre agent évaluateur, puis l’humain, le plus riche mais le plus cher
1. La réalité exécutable
Le feedback le plus honnête est celui qui ne peut pas mentir. Du code qui compile ou pas. Des tests qui passent ou pas. Une URL qui répond 200 ou 404. Un PDF dont le texte déborde de la page ou pas. Quand un agent de code lance les tests après chaque modification et repart corriger tant que ça casse, son juge est la réalité. C’est pour ça que les agents ont d’abord explosé chez les développeurs : leur terrain fournit un signal de vérité gratuit et instantané
2. Les données de résultat
Un cran au-dessus en horizon de temps : les chiffres que ton travail produit dans le monde réel. Notre exemple vécu chez Kryve, celui qui fait tourner ce blog : les requêtes réelles de la Search Console alimentent le choix des articles suivants. Une page qui prend des impressions sans clics déclenche une réécriture de son titre. Une requête qui monte sans page dédiée déclenche un article. Cette mise à jour en est un exemple : la page apparaissait sur « boucle de feedback d’agents IA » sans être cliquée, la boucle l’a renvoyée en réécriture. Le contenu s’améliore parce que le système écoute ce que Google lui renvoie
3. Un autre agent en évaluateur
Le pattern evaluator-optimizer au sens strict : un agent génère, un second agent critique avec une grille explicite (exactitude, style, complétude), et le premier révise. Ça marche à une condition non négociable : l’évaluateur doit avoir des critères précis et le droit de dire non. Un évaluateur à qui on demande « c’est bien ? » répond oui. Un évaluateur à qui on demande « vérifie chaque chiffre contre sa source et rejette au moindre écart » trouve des erreurs. On fait tourner ce pattern sur nos contenus : un agent rédige, un vérificateur passe derrière avec la consigne de réfuter, et ce qui ne survit pas à la critique ne part pas en ligne
4. L’humain dans la boucle
Le feedback le plus riche et le plus cher. Ta correction vaut de l’or à une condition : qu’elle soit capturée quelque part où l’agent la retrouvera. Si tu corriges la même erreur de ton chaque semaine et que rien ne l’enregistre, tu tournes en rond comme un hamster dans sa roue. La version qui marche : chaque correction humaine finit dans les instructions permanentes du système (un fichier de consignes, une mémoire, une règle datée). Corrigé une fois, appliqué pour toujours. C’est le geste qui transforme un agent IA en collaborateur qui progresse
La boucle de feedback dans les agents de 2026
Les agents grand public de 2026 intègrent déjà une partie de la boucle. À toi de brancher le bon signal et la bonne condition d’arrêt
Claude Code : les hooks lancent une commande à des moments précis, par exemple tes tests ou ton linter après chaque modification de fichier. Le résultat revient à l’agent, qui corrige avant de continuer
Codex et Claude Code : même sans hook, une consigne du type « lance les tests après chaque changement et ne t’arrête que quand ils passent tous, 3 essais maximum » crée une boucle avec la réalité. On compare les deux dans Codex vs Claude Code
ChatGPT Work : il découpe un projet en étapes et te demande validation aux moments importants. C’est l’humain dans la boucle, posé par défaut. Le fonctionnement est détaillé dans notre guide de ChatGPT Work
n8n : les Agents n8n embarquent des validations, et un workflow classique peut faire passer chaque sortie par un nœud de contrôle avant l’envoi. Notre tuto créer un agent IA avec n8n montre la mise en place
Boucle de feedback ou humain dans la boucle : quelle différence ?
La boucle de feedback est le circuit complet qui évalue et corrige le travail de l’agent. L’humain dans la boucle (human in the loop) est une des sources de feedback possibles : un humain valide ou corrige à un moment précis
Dans un système sain, les deux se combinent. Le signal automatique filtre l’essentiel des erreurs à chaque tour, et l’humain garde la main sur ce qui est irréversible : envoyer, publier, payer, supprimer
Ce qu’une boucle change concrètement
Prenons une tâche banale : rédiger une page de vente
Sans boucle : tu prompts, tu reçois un texte correct et générique, tu passes 40 minutes à le retravailler. À chaque nouvelle page, rebelote. La qualité dépend de ton énergie du jour
Avec une boucle : l’agent rédige, un évaluateur vérifie contre ta grille (promesse claire dans le premier écran, zéro claim invérifiable, un appel à l’action par section), l’agent révise, et le texte ne t’arrive que quand la grille est verte. Toi, tu fais la passe finale de goût, 5 minutes. Et ta correction de goût est enregistrée pour la page suivante
D’un côté tu relis des brouillons à vie, de l’autre tu reçois du travail pré-vérifié qui s’améliore tout seul. C’est aussi ce qui explique pourquoi certains domaines s’automatisent bien et d’autres pas : là où le feedback est objectif et rapide, les agents progressent vite. Là où personne ne peut dire si le résultat est bon, ils stagnent
Les erreurs qui coûtent cher
La boucle sans condition d’arrêt. Un agent qui itère « jusqu’à la perfection » peut brûler ton budget en tournant à vide. Toute boucle sérieuse a un critère de sortie ET un plafond d’itérations. Trois tours suffisent presque toujours ; au-delà, le problème vient du critère flou
L’évaluateur complaisant. Les modèles ont un biais naturel vers l’approbation. Un évaluateur sans grille précise valide tout, et ta boucle devient du théâtre. Le remède : des critères binaires, vérifiables, et une consigne explicite de chercher les défauts
Le faux feedback. Un agent peut produire le travail puis raconter qu’il l’a vérifié. La parade : faire venir le verdict d’un canal que le générateur ne contrôle pas, comme une exécution réelle, une donnée externe ou un évaluateur séparé
Optimiser le signal au lieu du travail. Un agent jugé uniquement sur « zéro test rouge » peut contourner le problème en affaiblissant les tests. Vérifie le résultat final et lis les traces, en plus du score. Anthropic insiste sur cette lecture des transcripts pour distinguer une vraie erreur d’un grader mal conçu
Le feedback jeté. Corriger en chat et ne rien consigner. La correction meurt avec la conversation, et tu repayes la même erreur la semaine suivante
Par où commencer, sans code
Tu n’as pas besoin d’infrastructure pour ta première boucle. Trois gestes, ce soir :
Donne un critère de sortie à tes tâches. Au lieu de « rédige un email », essaie : « rédige, puis relis en te demandant si chaque phrase apporte une information, coupe ce qui n’en apporte pas, et ne me montre que la version qui survit ». Une auto-boucle en un prompt. Pour structurer ce genre de consigne, suis notre méthode pour faire un bon prompt
Sépare le générateur du critique. Sur un travail qui compte, fais produire par une conversation et critiquer par une autre, avec une grille explicite. Deux perspectives valent mieux qu’une auto-évaluation
Crée ta mémoire de corrections. Un simple fichier de consignes que tu enrichis à chaque correction (« ne jamais dire X », « toujours vérifier Y en premier ») et que tu redonnes à chaque session. C’est la boucle la plus rentable qui existe, et celle que presque personne ne tient
Pour voir le mécanisme à l’échelle d’un système complet, comprendre comment une IA raisonne aide à saisir pourquoi la critique externe change tout : le modèle qui produit est rarement le mieux placé pour juger sa production
La limite honnête
Une boucle de feedback améliore ce qui est mesurable. Elle ne sauve pas une tâche mal définie : si tu ne peux pas dire ce qu’est un bon résultat, aucun évaluateur ne le dira à ta place. Elle a aussi un coût réel : chaque itération consomme des tokens, et sur les modèles chers, une boucle mal bornée se paie. Enfin, elle ne remplace pas la supervision sur les actions irréversibles : un agent qui envoie, publie ou supprime doit garder un humain dans sa boucle, précisément parce que le feedback arrive après l’action. Les modèles récents vont plus loin que ton intention plus souvent qu’on ne croit, on l’a détaillé dans notre comparatif des modèles frontière
FAQ
C’est quoi une boucle de feedback d’agents IA, en une phrase ?
Un circuit où la production d’un agent est évaluée (par des tests, des données, un autre agent ou un humain) et où cette évaluation nourrit l’itération suivante, jusqu’à atteindre le critère de qualité fixé
Quelle différence avec le RLHF ou le fine-tuning ?
Le RLHF améliore le modèle lui-même pendant son entraînement, chez le fournisseur. La boucle de feedback d’agents améliore le travail et le système autour du modèle, chez toi, sans rien réentraîner : mêmes modèles, résultats très différents
Qu’est-ce que l’humain dans la boucle pour un agent IA ?
C’est le moment où un humain valide, corrige ou autorise une action avant que l’agent continue. On le réserve aux décisions irréversibles ou sensibles, et chaque correction doit être enregistrée pour que l’agent ne refasse pas la même erreur
Comment ajouter une boucle de feedback à Claude Code ?
Le plus simple : un hook qui lance tes tests après chaque modification de fichier, et une consigne d’arrêt du type « continue tant que les tests échouent, 3 essais maximum, puis explique ce qui bloque »
Faut-il savoir coder pour mettre ça en place ?
Non. La version minimale tient en deux conversations (une qui génère, une qui critique avec une grille) et un fichier de consignes enrichi à chaque correction. Le code devient utile quand tu veux brancher du feedback objectif automatique, comme des tests ou des données de performance
Combien d’itérations faut-il autoriser ?
Deux à trois tours couvrent l’immense majorité des cas. Si un agent n’atteint pas le critère en trois itérations, le problème est presque toujours dans la définition du critère ou de la tâche. Et fixe toujours un plafond : une boucle sans limite est une facture sans limite
Avant de partir
Si cet article t’a donné envie de construire au lieu de juste lire : j’ai condensé le démarrage en un guide d’une soirée. Ton premier agent qui produit du travail réel, étape par étape, sans code. Gratuit, contre ton email. Tu recevras aussi Kryve Weekly, le condensé hebdo de ce qui compte en IA, sans le bruit
Un email pour te l’envoyer. Pas de spam, désinscription en un clic